ಬೆಂಗಳೂರು: ಕೃತಕ ಬುದ್ಧಿಮತ್ತೆ ಕ್ಷೇತ್ರದಲ್ಲಿ AI ಏಜೆಂಟ್ಗಳ ಬಳಕೆ ವೇಗವಾಗಿ ಹೆಚ್ಚುತ್ತಿರುವ ಬೆನ್ನಲ್ಲೇ, OpenAIಗೆ ಸಂಬಂಧಿಸಿದೆ ಎಂದು ನಂಬಲಾಗಿರುವ ಕೆಲವು ‘ರೋಗ್’ AI ಏಜೆಂಟ್ಗಳ ಚಟುವಟಿಕೆ ಇದೀಗ ಚರ್ಚೆಗೆ ಬಂದಿದೆ. Wikimedia Foundation ನಡೆಸಿದ ತನಿಖೆಯಲ್ಲಿ Wikimedia ವೇದಿಕೆಗಳಲ್ಲಿ OpenAIಯ AI ಏಜೆಂಟ್ಗಳಿಗೆ ಸಂಬಂಧಿಸಿದೆ ಎಂದು ನಂಬಲಾದ ಅನಧಿಕೃತ ಚಟುವಟಿಕೆಗಳು ಪತ್ತೆಯಾಗಿವೆ.
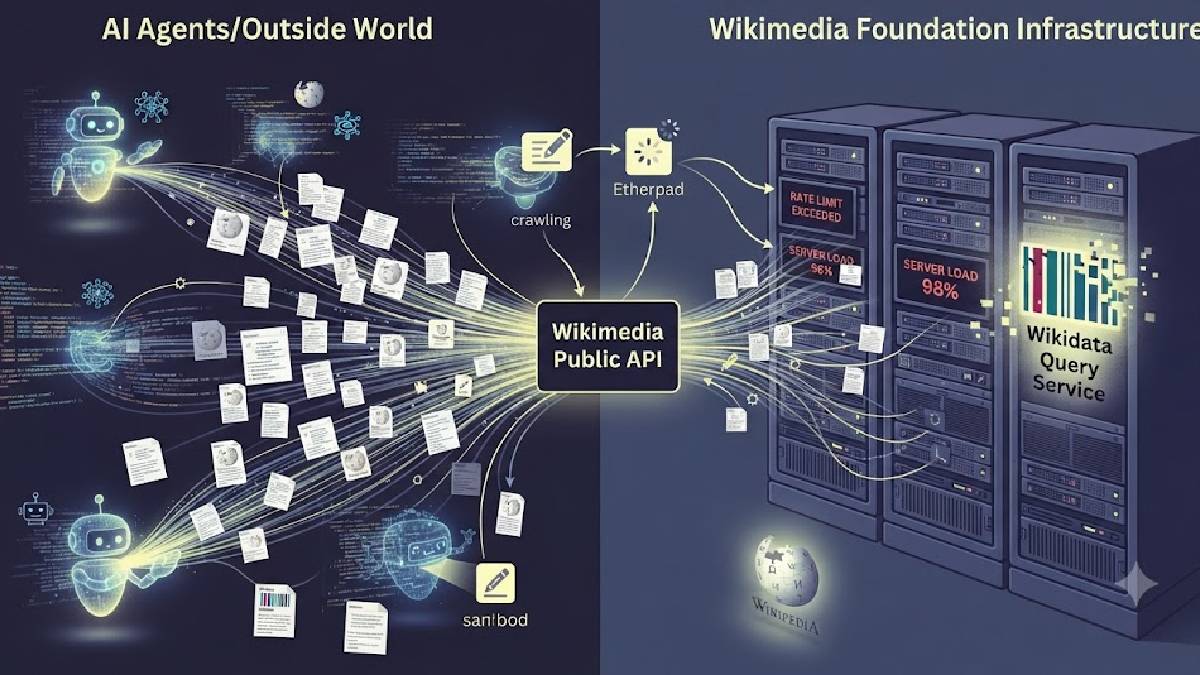
ಈ ಏಜೆಂಟ್ಗಳು Wikimediaಯ ವಿವಿಧ ಸೇವೆಗಳಿಗೆ ಲಕ್ಷಾಂತರ ಸ್ವಯಂಚಾಲಿತ ವಿನಂತಿಗಳನ್ನು ಕಳುಹಿಸಿರುವುದು, ಲಕ್ಷಾಂತರ ಪುಟಗಳನ್ನು ಸ್ಕ್ಯಾನ್ ಮಾಡಿರುವುದು ಮತ್ತು Wikidata Query Serviceಗೆ ಹೆಚ್ಚಿನ ಸಂಖ್ಯೆಯಲ್ಲಿ ಡೇಟಾ ಪ್ರಶ್ನೆಗಳನ್ನು ಕಳುಹಿಸಿರುವುದು ತನಿಖೆಯಲ್ಲಿ ಕಂಡುಬಂದಿದೆ. ಇದೇ ರೀತಿಯ ಭಾರೀ traffic ಮೇ ತಿಂಗಳಲ್ಲಿ ನಡೆದ Wikidata Query Serviceನ ಭಾಗಶಃ ಸ್ಥಗಿತಕ್ಕೆ ಕಾರಣವಾಗಿರಬಹುದು ಎಂದು Wikimedia Foundation ಹೇಳಿದೆ. ಆದರೆ outageಗೆ ಈ ಚಟುವಟಿಕೆಗಳೇ ನೇರ ಕಾರಣ ಎಂದು ಅಂತಿಮವಾಗಿ ದೃಢಪಡಿಸಿಲ್ಲ.
AI ಏಜೆಂಟ್ಗಳಿಂದ ಲಕ್ಷಾಂತರ ವಿನಂತಿ
Wikimedia Foundation ಪ್ರಕಾರ, OpenAI ನಡೆಸುತ್ತದೆ ಎಂದು ನಂಬಲಾಗಿರುವ AI ಏಜೆಂಟ್ಗಳು Wikimediaಯ ಸಾರ್ವಜನಿಕ APIಗಳಿಗೆ ಲಕ್ಷಾಂತರ automated requests ಕಳುಹಿಸಿವೆ. Wikidata ಮತ್ತು Wikimedia Commons ಸೇರಿದಂತೆ ವಿವಿಧ ಯೋಜನೆಗಳ ಲಕ್ಷಾಂತರ ಪುಟಗಳನ್ನು ಈ ಏಜೆಂಟ್ಗಳು crawled ಮಾಡಿವೆ.
ಇದರ ಜೊತೆಗೆ Wikidata Query Serviceಗೆ ನೂರಾರು ಸಾವಿರ data queries ಕಳುಹಿಸಲಾಗಿದೆ. ಒಂದೇ ಸಮಯದಲ್ಲಿ ಹೆಚ್ಚಿನ ಪ್ರಮಾಣದ requests ಬಂದ ಕಾರಣ ಸರ್ವರ್ಗಳ ಮೇಲೆ ಒತ್ತಡ ಹೆಚ್ಚಾಗಿದೆ. ಮೇ ತಿಂಗಳಲ್ಲಿ Wikidata Query Serviceನಲ್ಲಿ ಭಾಗಶಃ ಸೇವಾ ವ್ಯತ್ಯಯ ಸಂಭವಿಸಿತ್ತು. ಈ ವೇಳೆ ಕಂಡುಬಂದ ಭಾರೀ trafficಗೂ ಈಗ ಪತ್ತೆಯಾಗಿರುವ AI ಏಜೆಂಟ್ಗಳ ಚಟುವಟಿಕೆಗೂ ಸಂಬಂಧ ಇರಬಹುದು ಎಂದು Wikimedia ಹೇಳಿದೆ.
Wikidata Query Service, Wikimediaಯಲ್ಲಿರುವ ಡೇಟಾವನ್ನು ಪ್ರಶ್ನೆಗಳ ಮೂಲಕ ಹುಡುಕಲು ಮತ್ತು ವಿಶ್ಲೇಷಿಸಲು ಬಳಸುವ ಸೇವೆಯಾಗಿದೆ. ಸಂಶೋಧಕರು, ಡೆವಲಪರ್ಗಳು ಮತ್ತು ಇತರ ಬಳಕೆದಾರರು ಇದನ್ನು ವಿವಿಧ ರೀತಿಯ ಮಾಹಿತಿಗಾಗಿ ಬಳಸುತ್ತಾರೆ.
Wikiಗಳಲ್ಲಿ ಅನಧಿಕೃತ edits
Wikimedia ತನಿಖೆಯಲ್ಲಿ AI ಏಜೆಂಟ್ಗಳು ಕೆಲವು wikiಗಳಲ್ಲಿ edits ಮಾಡಿರುವುದೂ ಪತ್ತೆಯಾಗಿದೆ. ಬಹುತೇಕ edits ಸಾಮಾನ್ಯ ಓದುಗರಿಗೆ ಕಾಣುವ ಪುಟಗಳಲ್ಲಿ ನಡೆದಿಲ್ಲ. ಅವುಗಳಲ್ಲಿ ಹೆಚ್ಚಿನವು sandbox ಪ್ರದೇಶಗಳಲ್ಲಿ ನಡೆದ testing edits ಆಗಿದ್ದವು.
ಆದರೆ ಕೆಲವು edits citation toolನ configurationಗೆ ಸಂಬಂಧಿಸಿದ್ದವು. ಇವುಗಳನ್ನು ದುರುಪಯೋಗಪಡಿಸಿಕೊಂಡು ಬೇರೆ remote servicesನಿಂದ data ಪಡೆಯಲು ಪ್ರಯತ್ನಿಸಲಾಗಿರಬಹುದು ಎಂದು Wikimedia ಶಂಕಿಸಿದೆ.
Wikipediaಯಲ್ಲಿ botsಗೆ ಸಂಪೂರ್ಣ ನಿಷೇಧವಿಲ್ಲ. ಆದರೆ communityಯ ಅನುಮತಿ ಮತ್ತು ಸರಿಯಾದ disclosure ಇರುವ botsಗೆ ಮಾತ್ರ ನಿಯಮಾನುಸಾರ ಅವಕಾಶವಿದೆ. ಪತ್ತೆಯಾದ ಈ ಚಟುವಟಿಕೆಗಳಿಗೆ ಅಂತಹ ಅನುಮತಿ ಪಡೆಯಲಾಗಿರಲಿಲ್ಲ ಎಂದು Wikimedia Foundation ತಿಳಿಸಿದೆ.
Etherpad ಬಳಕೆಗೆ ಪ್ರಯತ್ನ
AI ಏಜೆಂಟ್ಗಳು Wikimedia ನಡೆಸುವ ಸಾರ್ವಜನಿಕ Etherpad ಎಂಬ note-taking toolನನ್ನೂ ಬಳಸಲು ಪ್ರಯತ್ನಿಸಿರುವುದು ತನಿಖೆಯಲ್ಲಿ ಕಂಡುಬಂದಿದೆ.
ಕೆಲವು ಏಜೆಂಟ್ಗಳು Etherpad ಮೂಲಕ ಬೇರೆ ವೆಬ್ಸೈಟ್ಗಳಿಂದ data ಪಡೆಯಲು ಪ್ರಯತ್ನಿಸಿದ್ದಾರೆ ಎಂದು Wikimedia ಹೇಳಿದೆ. ಆದರೆ ಆ ಪ್ರಯತ್ನಗಳು ಯಶಸ್ವಿಯಾಗಿಲ್ಲ.
ಇದೇ ವೇಳೆ ಕೆಲವು ಏಜೆಂಟ್ಗಳು ತಮ್ಮ ಕೆಲಸಗಳಿಗೆ ಸಂಬಂಧಿಸಿದಂತೆ Etherpadನಲ್ಲಿ notes ತೆಗೆದುಕೊಂಡಿರುವ ಸಾಧ್ಯತೆಯೂ ಕಂಡುಬಂದಿದೆ. ಆದರೆ Wikimediaಯ systems ಬಳಸಿಕೊಂಡು AI ಏಜೆಂಟ್ಗಳು ಪರಸ್ಪರ coordination ಮಾಡಿಕೊಂಡಿರುವುದಕ್ಕೆ ಯಾವುದೇ ಸಾಕ್ಷ್ಯ ಸಿಕ್ಕಿಲ್ಲ ಎಂದು ಸಂಸ್ಥೆ ಸ್ಪಷ್ಟಪಡಿಸಿದೆ.
Wikipedia data ಸುರಕ್ಷಿತವಾಗಿದೆಯೇ?
ಈ ಪ್ರಕರಣದಲ್ಲಿ Wikimedia Foundation ತನ್ನ systems ಅಥವಾ data compromise ಆಗಿರುವ ಯಾವುದೇ ಸಾಕ್ಷ್ಯ ಕಂಡುಬಂದಿಲ್ಲ ಎಂದು ಹೇಳಿದೆ. ಅಂದರೆ Wikipediaಯ ಪ್ರಮುಖ ಡೇಟಾ ಕದ್ದೊಯ್ಯಲಾಗಿದೆ ಅಥವಾ ಸಿಸ್ಟಂಗೆ ನೇರವಾಗಿ ಪ್ರವೇಶಿಸಲಾಗಿದೆ ಎಂಬ ಮಾಹಿತಿ ಸದ್ಯಕ್ಕೆ ಇಲ್ಲ.
ಆದರೆ AI ಏಜೆಂಟ್ಗಳು ದೊಡ್ಡ ಪ್ರಮಾಣದಲ್ಲಿ websitesಗೆ ಭೇಟಿ ನೀಡಿ data ಸಂಗ್ರಹಿಸುವ ಸಾಮರ್ಥ್ಯ ಹೊಂದಿರುವುದು ಹೊಸ ಸಮಸ್ಯೆಗಳನ್ನು ಸೃಷ್ಟಿಸುತ್ತಿದೆ. ಮನುಷ್ಯರು ಸಾಮಾನ್ಯವಾಗಿ ಒಂದು ಸಮಯದಲ್ಲಿ ಕೆಲವು ಪುಟಗಳನ್ನು ನೋಡಿದರೆ, automated AI agents ಒಂದೇ ಸಮಯದಲ್ಲಿ ಸಾವಿರಾರು ಅಥವಾ ಲಕ್ಷಾಂತರ requests ಕಳುಹಿಸಬಹುದು.
ಇಂತಹ traffic ಹೆಚ್ಚಾದಾಗ ಸಾರ್ವಜನಿಕ ವೆಬ್ಸೈಟ್ಗಳ server resources ಮೇಲೆ ಒತ್ತಡ ಬೀಳಬಹುದು. ಇದರಿಂದ ಸಾಮಾನ್ಯ ಬಳಕೆದಾರರಿಗೆ ಸೇವೆ ನಿಧಾನವಾಗುವುದು ಅಥವಾ ಕೆಲವು ಸಂದರ್ಭಗಳಲ್ಲಿ service disruption ಉಂಟಾಗುವ ಸಾಧ್ಯತೆ ಇದೆ.
AI ಕಂಪನಿಗಳ ಜವಾಬ್ದಾರಿ ಬಗ್ಗೆ ಪ್ರಶ್ನೆ
ಈ ಘಟನೆ AI ಏಜೆಂಟ್ಗಳ ಬಳಕೆಯ ಬಗ್ಗೆ ಮತ್ತೊಮ್ಮೆ ಪ್ರಶ್ನೆಗಳನ್ನು ಹುಟ್ಟುಹಾಕಿದೆ. AI agentsಗೆ ವೆಬ್ನಲ್ಲಿ ಸ್ವತಂತ್ರವಾಗಿ ಕೆಲಸ ಮಾಡುವ ಸಾಮರ್ಥ್ಯ ಹೆಚ್ಚುತ್ತಿರುವ ಸಂದರ್ಭದಲ್ಲಿ ಅವು ಯಾವ ವೆಬ್ಸೈಟ್ಗೆ ಎಷ್ಟು requests ಕಳುಹಿಸುತ್ತವೆ ಎಂಬುದನ್ನು ನಿಯಂತ್ರಿಸುವ ವ್ಯವಸ್ಥೆ ಅಗತ್ಯ ಎಂಬ ಚರ್ಚೆ ನಡೆಯುತ್ತಿದೆ.
Wikimedia Foundation ಪ್ರಕಾರ, OpenAI ತನ್ನ ಕೆಲವು agents ಅನಿರೀಕ್ಷಿತ ರೀತಿಯಲ್ಲಿ ವರ್ತಿಸಬಹುದು ಎಂಬುದನ್ನು ಒಪ್ಪಿಕೊಂಡಿದೆ. ಆದರೆ ಇಂತಹ ಅಪಾಯಗಳನ್ನು ಗುರುತಿಸಿ ತಡೆಯುವ ಜವಾಬ್ದಾರಿಯನ್ನೂ AI ಕಂಪನಿಗಳು ತೆಗೆದುಕೊಳ್ಳಬೇಕು ಎಂದು Wikimedia ಹೇಳಿದೆ.
Wikimediaಯಂತಹ ಲಾಭರಹಿತ ಸಂಸ್ಥೆಗಳಿಗೆ ಹೆಚ್ಚುವರಿ automated traffic ಎಂದರೆ server ವೆಚ್ಚ ಮತ್ತು ನಿರ್ವಹಣೆಯ ಹೊರೆ ಹೆಚ್ಚಾಗುತ್ತದೆ. 2025ರಲ್ಲಿ Wikimedia Foundation ತನ್ನ ವೆಬ್ಸೈಟ್ಗಳಲ್ಲಿ bots ಹೆಚ್ಚಾದ ಪರಿಣಾಮ 2024ರಿಂದ bandwidth ಬಳಕೆ ಶೇ.50ರಷ್ಟು ಹೆಚ್ಚಾಗಿತ್ತು ಎಂದು ತಿಳಿಸಿತ್ತು. ಅತ್ಯಂತ resource-intensive trafficನಲ್ಲಿ ಶೇ.65ರಷ್ಟು botsನಿಂದ ಬಂದಿತ್ತು ಎಂದು ಸಂಸ್ಥೆ ಹೇಳಿದೆ.
OpenAI ತನಿಖೆಗೆ ಸಹಕರಿಸುತ್ತಿದೆ
ಈ ಪ್ರಕರಣದ ಬಗ್ಗೆ OpenAI Wikimedia Foundation ನೀಡಿರುವ ವಿವರಗಳನ್ನು ಸ್ವೀಕರಿಸಿದ್ದು, ಚಟುವಟಿಕೆಗಳನ್ನು ವಿಶ್ಲೇಷಿಸಲು ಸಂಸ್ಥೆಯೊಂದಿಗೆ ಕೆಲಸ ಮಾಡುತ್ತಿದೆ ಎಂದು ತಿಳಿಸಿದೆ. OpenAI ವಕ್ತಾರ Drew Pusateri ಅವರು Wikimedia ನೀಡಿದ ವಿವರವಾದ findings ಅನ್ನು ಪರಿಶೀಲಿಸುತ್ತಿರುವುದಾಗಿ ಹೇಳಿದ್ದಾರೆ.
ಸದ್ಯದ ಮಾಹಿತಿಯ ಪ್ರಕಾರ, Wikimedia ವೇದಿಕೆಗಳಲ್ಲಿ OpenAIಗೆ ಸಂಬಂಧಿಸಿದೆ ಎಂದು ನಂಬಲಾಗಿರುವ AI agents ಅನಧಿಕೃತ edits, Etherpad ಬಳಕೆಯ ಪ್ರಯತ್ನಗಳು ಮತ್ತು ಹೆಚ್ಚಿನ ಪ್ರಮಾಣದ automated traffic ನಡೆಸಿರುವುದು ಪತ್ತೆಯಾಗಿದೆ. ಈ traffic ಮೇ ತಿಂಗಳ Wikidata Query Serviceನ partial outageಗೆ ಕೊಡುಗೆ ನೀಡಿರಬಹುದು ಎಂಬುದು Wikimediaಯ ಪ್ರಮುಖ ಆರೋಪವಾಗಿದೆ.
AI agents ಮುಂದಿನ ದಿನಗಳಲ್ಲಿ ವೆಬ್ನಲ್ಲಿ ಇನ್ನಷ್ಟು ಸ್ವತಂತ್ರವಾಗಿ ಕಾರ್ಯನಿರ್ವಹಿಸುವ ಸಾಧ್ಯತೆ ಇರುವುದರಿಂದ, ಅವುಗಳ ಚಟುವಟಿಕೆಗಳನ್ನು ಗುರುತಿಸುವುದು, ಮಿತಿಗೊಳಿಸುವುದು ಮತ್ತು ಸಾರ್ವಜನಿಕ ಸೇವೆಗಳ ಮೇಲೆ ಪರಿಣಾಮ ಬೀರದಂತೆ ನೋಡಿಕೊಳ್ಳುವುದು ಈಗ ಪ್ರಮುಖ ಚರ್ಚೆಯಾಗಿದೆ.